✦ SXSEditor v2.0.2 现已发布 ✦ 日语实验性支持上线 · 汉字假名自动分组 ✦ DirectML GPU 推理速度最高提升 6 倍 ✦ 三精度模型共存:FP32 / FP16 / INT8 自由切换 ✦ 新增 SiFiGAN 声码器 · mel SNR 提升至 83.54 dB
VERSION 2.0.2「SoulX-Singer」 ONNX Runtime · DirectML

让每个音符,
都为你歌唱

SXSEditor 是一款开源的 AI 歌声合成(SVS)桌面应用——基于 SoulX-Singer 神经模型 × ONNX Runtime 推理 × DirectML GPU 加速,从 MIDI 音符与歌词到完整歌声,一个软件走完全部流程。

支持 Windows · macOS · Linux | MIT 开源协议 | 三语合成:中 · 英 · 日
0合成语言
0模型精度
0GPU 加速比
SXSEditor // FRAGMENT EDITOR v2.0.2
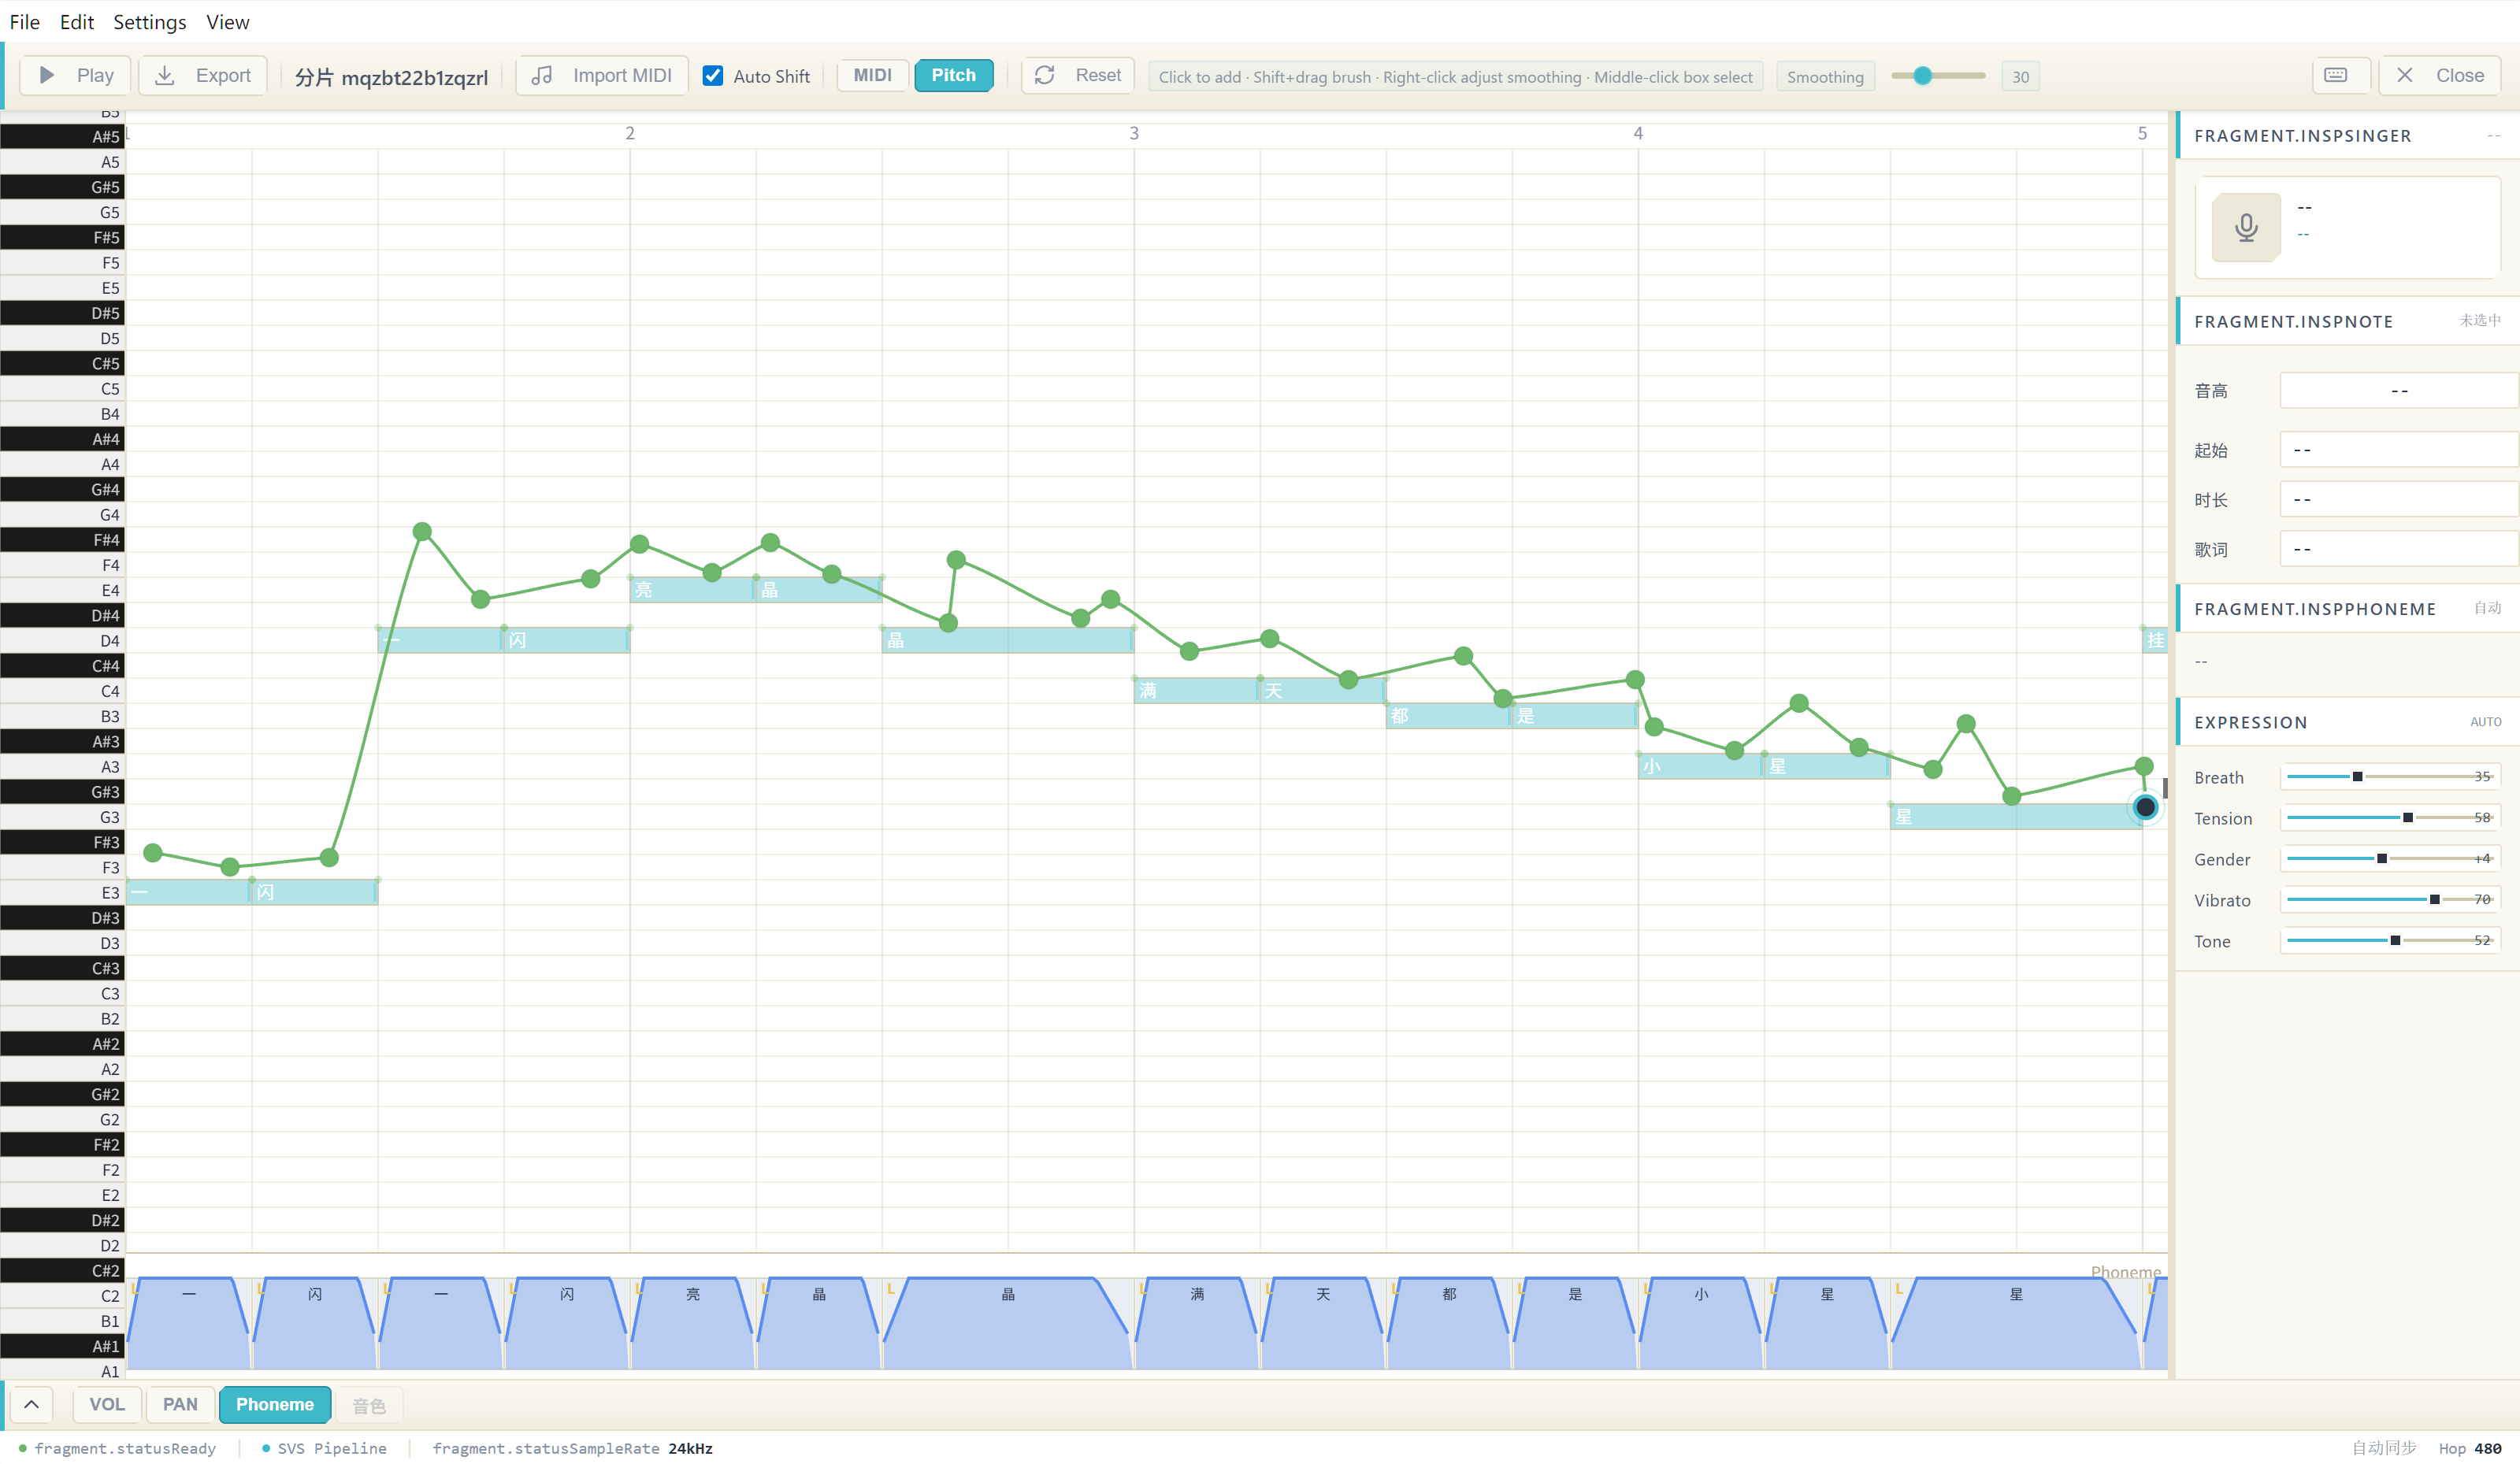
SXSEditor 片段编辑器界面
实时合成 音域 C2 – G5 中 · 英 · 日 跨语种
ONNX Runtime 推理
DirectML · GPU6x 加速
DEMO TRACK — demo.sxsproj
♩ = 132
FEATURE

核心功能

为歌声合成而生的创作工作台
01

SoulX-Singer 神经合成

深度学习歌声合成模型,运行于 ONNX Runtime 之上。DirectML GPU 加速将声码器推理速度提升 6 倍,mel 频谱前端信噪比从 49.86 dB 提升到 83.54 dB。中英日三语跨语种合成,同一模型自由演唱多语言曲目。

AI 声线跨语种合成ONNX opset 20
6xGPU 加速比
83dBmel SNR
W16A32量化精度
02

钢琴卷帘编辑器

音符、歌词、音高曲线、音量/声像包络,以及音素级边界编辑。所画即所听,参数修改即时反馈。

音高笔刷MIDI 导入音素边界
03

多语种咬字对齐

输入歌词自动切分音节,中文拼音 / 英文音素 / 日文假名智能标注,逐字对齐到毫秒级。

xīng huī qióng xiǎng
自动注音汉字假名分组
04

多精度模型共存

FP32(推荐)/ FP16 / INT8 / INT8-NPU 多精度模型共存,切换无需重新下载。W16A32 量化在降低显存占用的同时接近 FP32 质量。

FP32FP16INT8
05

多后端推理

单一二进制支持 DirectML GPU、WebNN NPU/GPU 与 CPU 回退,自动选择最优后端。

DirectMLWebNNNPUCPU
06

音频转 MIDI

FCPE 音高检测器(默认)或 basic_pitch 将现有音频转换为 MIDI 音符,可选同时提取 F0 音高曲线。

F0 / MIDI 自动提取
DOWNLOAD

获取 SXSEditor

MIT 开源 · 个人创作永久免费 · 模型首次启动自动下载
推荐平台
Windows 版STABLE RELEASE

最新版本 v2.0.2 · 64 位安装包 · 模型按需下载

系统要求:Windows 10 / 11(64 位)· 8GB 内存 · 推荐 4GB+ VRAM 独立显卡

前往 GitHub 最新发行版
GitCode 镜像CODE MIRROR

代码镜像 · gitcode.com/qq_50331623/SXSEditor

GitCode 现仅同步源代码镜像,不再托管发行版安装包。安装包请通过 GitHub 最新发行版获取。

查看代码镜像
源码构建MACOS · LINUX

仓库:github.com/Henley04/SXSEditor

macOS / Linux 用户请克隆仓库从源码构建。需 Node.js 与 Electron Forge。

查看构建指南
历史版本与发布说明详见 GitHub Releases 查看历史版本 →

更新日志

  • WindowsML TensorRT-RTX 执行提供器——FP16 模型可通过 WinML 的 NvTensorRT EP 在 NVIDIA GPU 上运行,RTX 5060 Laptop 下 FP16 推理较 DML FP32 提升约 4 倍
  • 原生推理后端选择器——以统一的后端选择(TensorRT-RTX / DML / WebNN / CPU)取代旧 WinML 复选框,自动回退
  • 第三方 EP 全零输出保护——通过 D2H ArrayBuffer 复制回退(d2h-copy-v3 原生桥接)与应用级全零检测兜底
  • 移除 GPU 排空延迟——仅在显存不足后施加等待,减少扩散循环空闲开销
  • 流式 chunk 续播缓存——回拉重放复用已缓存 chunk,避免重复推理
  • 保留 MIDI 时间线间隔——流式合成不再折叠轨道的间隔区域
  • 人声区域切分——非人声与长休止从模型输入中切分,消除休止噪声、避免长休止后人声重叠
  • FCPE 音高检测器——新增基于 ONNX 的 FCPE 检测器作为默认 MIDI 提取工具,替代 Basic Pitch 成为推荐选项
  • 伴奏轨道——可导入 WAV/MP3/FLAC 等音频作为伴奏轨道,支持多声道播放、逐轨道音量控制与时间线拖拽
  • 可切换扩散采样器——Euler / Heun / 外推 Euler / STORK-2(ICLR 2026)四种求解器,预览与导出可分别配置
  • 动态阈值——逐帧百分位裁剪(arXiv:2507.08965),集成到 DML 与 WebNN 双路径
  • 歌手市场——浏览并下载社区创建的歌手,含独立使用条款页面
  • 音符右键菜单:颤音与渐入渐出——逐音符微调颤音参数与音量渐变,含预设与视觉指示
  • 48kHz 默认播放与导出采样率选择——默认采样率从 24kHz 改为 48kHz,导出可选 24/44.1/48/96kHz
  • 段落级合成缓存——迭代编辑长曲目时跳过未变更段落的重新推理
  • 协作式合成取消——基于 AbortController 替代 worker.terminate(),修复 D3D 设备挂起崩溃
  • EBU R128 响度归一化与 WSOLA 交叉淡变——统一响度并平滑 chunk 边界过渡
  • 打包体积减少约 527 MB(32%)——ort-web 去重、source map 裁剪、语言包裁剪
  • DML CFG 批量合并——条件与非条件预测合并为单次 session.run,推理往返减半
  • LRC 歌词导出 · QDIT int8 diff_step 模型支持 · 磁性边界吸附
  • 安全加固——模型文件路径校验、下载 URL 白名单、设置信任边界、前缀混淆防护
  • 修复:MIDI 歌词解码乱码 · cfg=0 未跳过无条件预测 · WebNN 张量泄漏 · 长分片卡顿等
  • 可拖拽播放头跳转——主页面、音频预处理页面与分片编辑器的播放头现可拖拽到任意位置开始播放
  • diffStep 分块推理加速预览——将扩散循环切分为多个 chunk,预览时按 chunk 流式推送音频,大幅缩短长分片的首音到达时间
  • Play All 多分片时间顺序流式播放——多个分片作为一条连续时间线合成与播放,而非顺序逐个处理
  • 通过 onChunkMel 按 chunk 流式推送音频——实现真正的流式合成,无需等待整个扩散循环完成
  • 日语发音全面优化——默认日语发声方式改为「混合音素」,混合模式还新增粤语 yue_ 音素覆盖
  • 汉字字典扩展至全部 2136 个常用汉字——大幅降低日语歌词中出现未解析汉字的概率
  • MIDI 导入 BPM / 拍号同步提示——导入 MIDI 时会询问是否从文件同步项目的 BPM 与拍号
  • ORT session 选项开放为设置——进阶用户可调校执行提供器与线程数
  • 设置页模型状态总览——一目了然显示已安装精度与版本
  • 基础模型精度与扩散模型分离——单个基础精度可被多个扩散模型精度复用
  • 官网首页重建——基于新模板重建,支持中英双语并提供中文洛天依演示音频
  • 启动优化 v2——重型模块推迟到 splash 窗口绘制完成后再加载,禁用未使用的 Chromium 特性以加速冷启动
  • 修复歌声比 MIDI 音符更早出现——所有播放 / 导出路径现均与 MIDI 音符位置对齐
  • 修复分段流式播放不完整——新增「等待推理」UI 在缓冲前沿暂停播放头直到下一个 chunk 到达
  • 修复流式分块推理的多个问题——流式预览在分片边界处也能可靠工作
  • 修复播放头拖拽到末尾后跳回起点、流式 chunk 到达时播放头不动等问题
  • 修复 @tonejs/midi 丢弃轨道级歌词——此前 MIDI 导入时丢失的轨道级歌词现已恢复
  • 修复 FP16 / FP32 输入类型不匹配——推理管道在检测到不匹配时会自动用修正后的 dummy inputs 重试
  • 清除 git 历史中的 ModelScope 凭据——新增防护以防止未来再次泄漏
  • 修复模型下载百分比溢出——进度百分比现在限制在 [0, 100] 范围内
  • 修复远程文件大小检测不准确——改用 Range 请求通过 Content-Range 头返回正确文件大小
  • 修复 formatBytes 浮点精度误差导致的文件大小显示异常
  • 修复 SiFiGAN 下载进度每个文件重置为 0——进度现在在下载批次的所有文件中累计
  • 实验性日语支持——汉字假名自动分组、混合音素模式(ら行 L / お段 AO)
  • 片段选择与删除——点击选中、Delete 键或右键菜单删除
  • ACG 默认主题与界面重构
  • 右键音高平滑度控制——逐锚点调整平滑强度
  • 带精度选择的导出对话框
  • 应用内更新检查器:应用与模型双通道检测,24 小时至多自动检查一次
  • 按精度模型版本追踪——切换精度不再使无关缓存条目失效
  • 动画自定义复选框、窗口弹出动效
  • SXSEditor 正式开源,MIT 协议发布
  • 基于 SoulX-Singer 神经模型,ONNX Runtime 推理
  • DirectML GPU / WebNN NPU / CPU 三后端共存
  • 钢琴卷帘编辑器:音符、歌词、音高曲线、音素级编辑
  • 歌手创建:30 秒纯人声样本构建专属歌手